Gemini Robotics ER 2 เปิด Preview: โมเดลเหตุผลเชิงพื้นที่สำหรับงานหุ่นยนต์
Google Cloud เปิด Preview ของ Gemini Robotics ER 2 สำหรับ spatial reasoning, video understanding และการประสานงานหุ่นยนต์หลายขั้น พร้อมข้อควรทดสอบด้านความปลอดภัย
Gemini Robotics ER 2 เปิด Preview: โมเดลเหตุผลเชิงพื้นที่สำหรับงานหุ่นยนต์
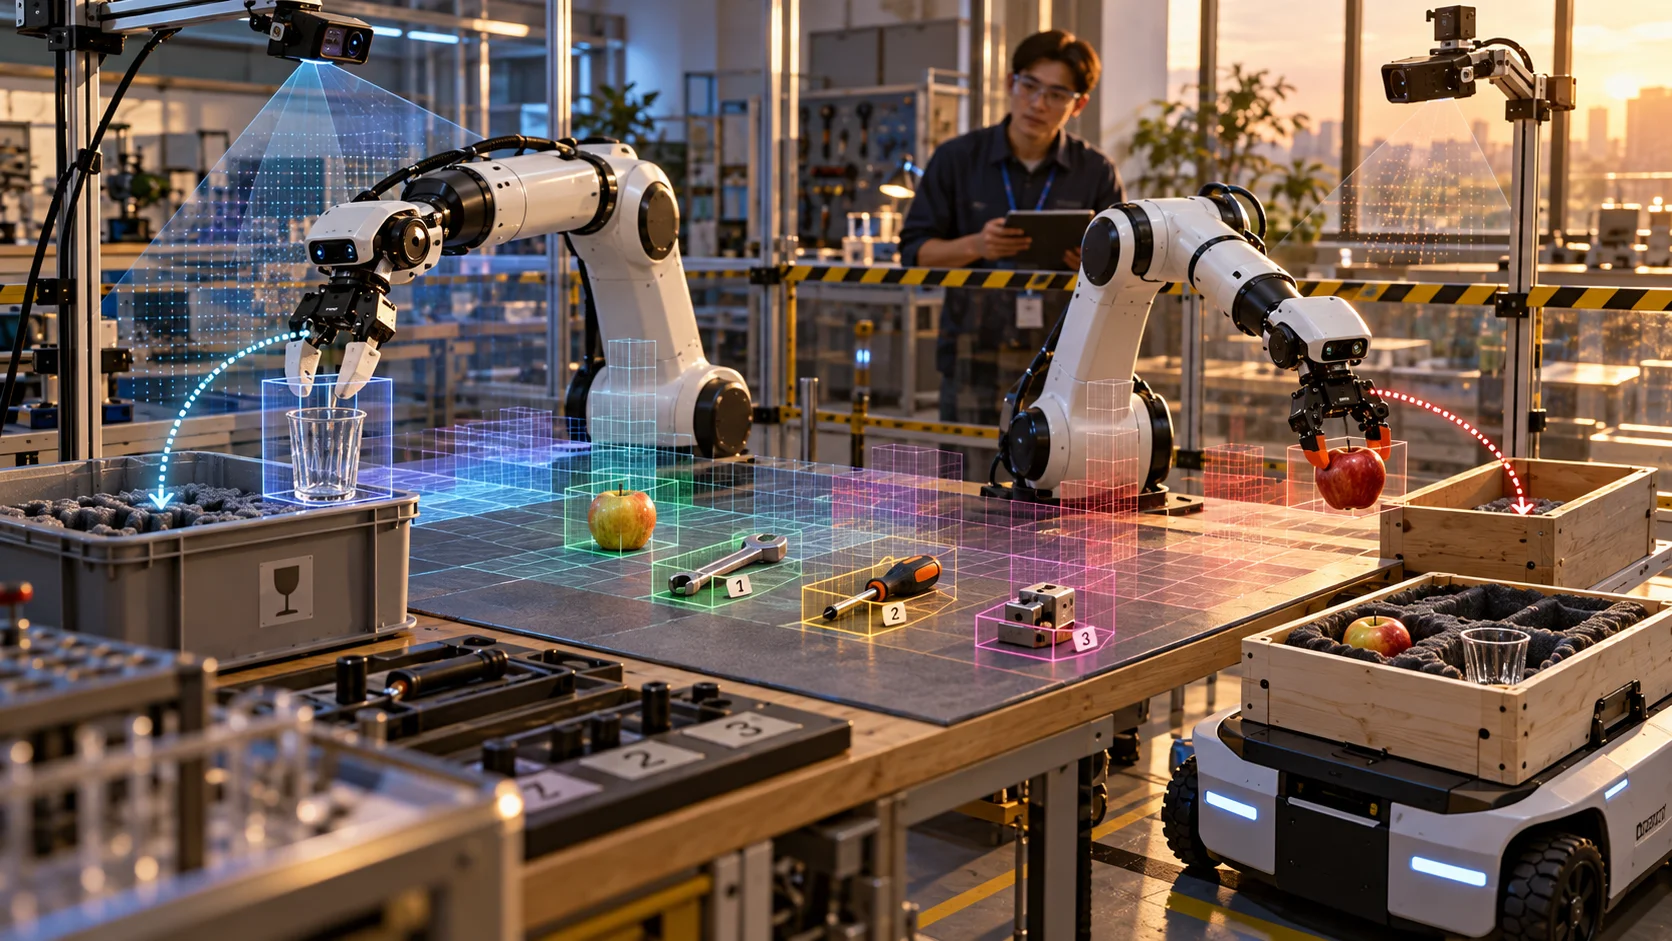
Google Cloud ประกาศวันที่ 27 ตุลาคม 2026 ว่า gemini-robotics-er-2-preview พร้อมให้ทดลองบน Gemini Enterprise Agent Platform โมเดลนี้เป็น vision-language model ที่พัฒนาบน Gemini 3.5 Flash โดยเน้นการตีความสภาพแวดล้อมทางกายภาพของหุ่นยนต์ ความสามารถที่ Google ระบุมีตั้งแต่การชี้ตำแหน่งวัตถุ การให้เหตุผลเชิงพื้นที่ การทำความเข้าใจวิดีโอและความคืบหน้าของงาน ไปจนถึงการประสานหลายขั้นตอนกับเครื่องมือหรือ API ของหุ่นยนต์ ข่าวนี้สำคัญกับทีมที่กำลังทดลองเชื่อมโมเดลภาษากับกล้องและการเคลื่อนไหวจริง เพราะผลลัพธ์ต้องถูกประเมินต่างจากแชตบอตทั่วไป: ความผิดพลาดอาจกระทบวัตถุ คน หรือเครื่องจักรในพื้นที่
โมเดลทำอะไรได้ตามเอกสาร
คู่มือของ Google อธิบายว่าโมเดลรับภาพ วิดีโอ หรือเสียงพร้อมคำสั่งภาษาธรรมชาติ แล้วส่งผลการวิเคราะห์เป็นข้อความหรือข้อมูลที่จัดรูปแบบ เช่น จุดพิกัดหรือ bounding boxes สำหรับวัตถุในภาพ ตัวอย่างในคู่มือให้โมเดลชี้ตำแหน่งวัตถุและคืนพิกัดสองมิติแบบ normalized ช่วง 0 ถึง 1000 ทีมพัฒนาสามารถนำผลนี้ไปประกอบกับ robotics API หรือ vision-language-action model เพื่อสร้างขั้นตอนการหยิบจับ แต่โมเดลไม่ได้ทำให้แขนกลเคลื่อนอย่างปลอดภัยด้วยตัวมันเอง ระบบควบคุมการเคลื่อนไหวต้องตรวจขอบเขตและสภาพแวดล้อมก่อนสั่ง actuator
Google แยกความสามารถเป็นสี่กลุ่มที่ควรทดสอบต่างกัน ได้แก่ spatial reasoning สำหรับระบุตำแหน่งและเส้นทาง, agentic code execution สำหรับการซูมหรือตัดภาพและอ่านเครื่องมือ, task orchestration สำหรับแบ่งงานยาวเป็นขั้นตอนผ่าน API ที่ผู้พัฒนากำหนด และ video understanding สำหรับหาช่วงเหตุการณ์หรือประเมินความคืบหน้าจากวิดีโอ หากทีมต้องการใช้โมเดลกับงานตรวจสายการผลิต อาจเริ่มจากการประเมินวิดีโอว่าชิ้นงานผ่านจุดตรวจแล้วหรือไม่ ก่อนเพิ่มสิทธิ์ให้ระบบเสนอคำสั่งต่อหุ่นยนต์ การแยกขั้นเช่นนี้ทำให้รู้ว่าความผิดพลาดอยู่ที่การมองเห็น การวางแผน หรือการสั่งงาน
วิธีเริ่มทดลองและขอบเขต Preview
เอกสารระบุให้ใช้ Google Gen AI SDK กับ Gemini Enterprise Agent Platform โดยติดตั้ง google-genai, เปิด API ในโปรเจกต์ และยืนยันตัวตนด้วย Application Default Credentials จาก Google Cloud ตัวอย่างสร้าง client ด้วย enterprise=True, project ID ของตน และ location="global" สำหรับช่วง Preview endpoint มีเฉพาะ global ชื่อโมเดลที่ต้องเรียกคือ gemini-robotics-er-2-preview ทีมที่มีข้อกำหนดให้ข้อมูลประมวลผลในภูมิภาคเฉพาะจึงต้องตรวจเงื่อนไขนี้ก่อนนำภาพหรือวิดีโอจริงไปทดลอง
หน้าข้อมูลโมเดล ระบุว่าเป็น Preview เปิดตัววันที่ 27 ตุลาคม 2026 รองรับ GenerateContent API, structured output, function calling และ code execution แต่ไม่ได้รองรับทุกช่องทางใช้งานของโมเดล Gemini ทั่วไป เช่น Interactions API, Live API หรือ batch inference ตามตารางบนหน้าข้อมูลโมเดล การออกแบบแอปจึงควรตรวจ capability ตามชื่อโมเดลนี้โดยตรง ไม่ยกข้อสมมติจาก Gemini รุ่นอื่นมาใช้ทั้งหมด
ทดสอบแบบที่สะท้อนโลกจริง
การทดสอบไม่ควรใช้ภาพคมชัดจากมุมเดียวเท่านั้น ควรมีแสงต่างกัน วัตถุถูกบังบางส่วน ฉากหลังคล้ายวัตถุเป้าหมาย และตำแหน่งกล้องที่เปลี่ยนไป แล้ววัดความคลาดเคลื่อนของพิกัดเทียบกับข้อมูลที่มนุษย์ทำเครื่องหมายไว้ หากใช้วิดีโอ ให้ตรวจทั้งการหาช่วงเหตุการณ์และการระบุว่างานเสร็จจริงหรือไม่ เพราะการเห็นหุ่นยนต์เคลื่อนไม่ได้แปลว่าหยิบวัตถุสำเร็จ คำแนะนำของ Google คือครอปหรือซูมวัตถุเล็กที่เห็นไม่ชัด แยกงานซับซ้อนเป็นหลายขั้น และถามหลายครั้งเพื่อเปรียบเทียบผลในงานที่ต้องการความแม่นยำสูง
สำหรับการสั่งงานจริง ควรให้ชั้นควบคุมเฉพาะทางตรวจ output ทุกครั้ง เช่น พิกัดต้องอยู่ในพื้นที่ทำงานที่อนุญาต ความเร็วและแรงต้องไม่เกินข้อกำหนด และต้องมีระบบหยุดฉุกเฉินแยกจากโมเดล หากโมเดลตอบผิดรูปแบบหรือไม่แน่ใจ ควรหยุดขั้นตอนหรือส่งให้มนุษย์ตัดสินใจ ไม่ควรแปลงทุกคำตอบเป็นคำสั่งเคลื่อนไหวโดยตรง Google เตือนเองว่าโมเดลอาจให้ข้อมูลผิด โดยเฉพาะคำสั่งกำกวมหรือภาพที่ต่างจากข้อมูลที่เคยพบ และ query ที่ซับซ้อน ภาพละเอียดสูง หรือการตั้ง thinking ระดับสูงอาจเพิ่ม latency
ข้อมูลส่วนบุคคลและการปฏิบัติงาน
กล้องและไมโครโฟนในพื้นที่ทำงานอาจเก็บภาพหรือเสียงของบุคคล เอกสารของ Google มีข้อกำหนดให้แจ้งและขอความยินยอมในกรณีที่เก็บข้อมูลส่วนบุคคล รวมถึงลดการเก็บและเผยแพร่ข้อมูลเท่าที่ทำได้ เช่น เบลอใบหน้าและเลือกพื้นที่ทดลองที่ไม่มีบุคคลที่ระบุตัวตนได้ ทีมจึงควรจัดทั้งความปลอดภัยทางกายภาพและการคุ้มครองข้อมูลตั้งแต่การทดลอง ไม่ใช่ค่อยเพิ่มภายหลังเมื่อระบบจะนำขึ้นใช้งาน
Preview นี้เปิดพื้นที่ให้ผู้พัฒนาทดสอบการเชื่อมเหตุผลเชิงพื้นที่กับระบบหุ่นยนต์หลายขั้นตอน ประโยชน์จะชัดเมื่อวัดกับงานเฉพาะ เช่น การชี้ตำแหน่ง การอ่านเครื่องมือ หรือการตรวจความสำเร็จของงาน โดยมีเกณฑ์ผ่านที่วัดได้และทางหยุดที่ปลอดภัย การประกาศความสามารถของโมเดลยังไม่ใช่หลักฐานว่าเหมาะกับงานของทุกโรงงานหรือทุกระดับความเสี่ยง ทีมต้องประเมินกับอุปกรณ์และสภาพแวดล้อมของตนเองก่อนขยายการใช้งาน
แหล่งข้อมูล: Google Cloud Release Notes วันที่ 27 ตุลาคม 2026, คู่มือ Gemini Robotics ER 2 และ ข้อมูลโมเดล