BigQuery AI.PARSE_DOCUMENT เปิด GA แปลงเอกสารเป็น JSON ใน SQL
ฟังก์ชันใหม่ใช้ Document AI layout parser แยกหัวข้อ ตาราง และภาพจากไฟล์เป็น JSON เพื่อวิเคราะห์และทำ RAG
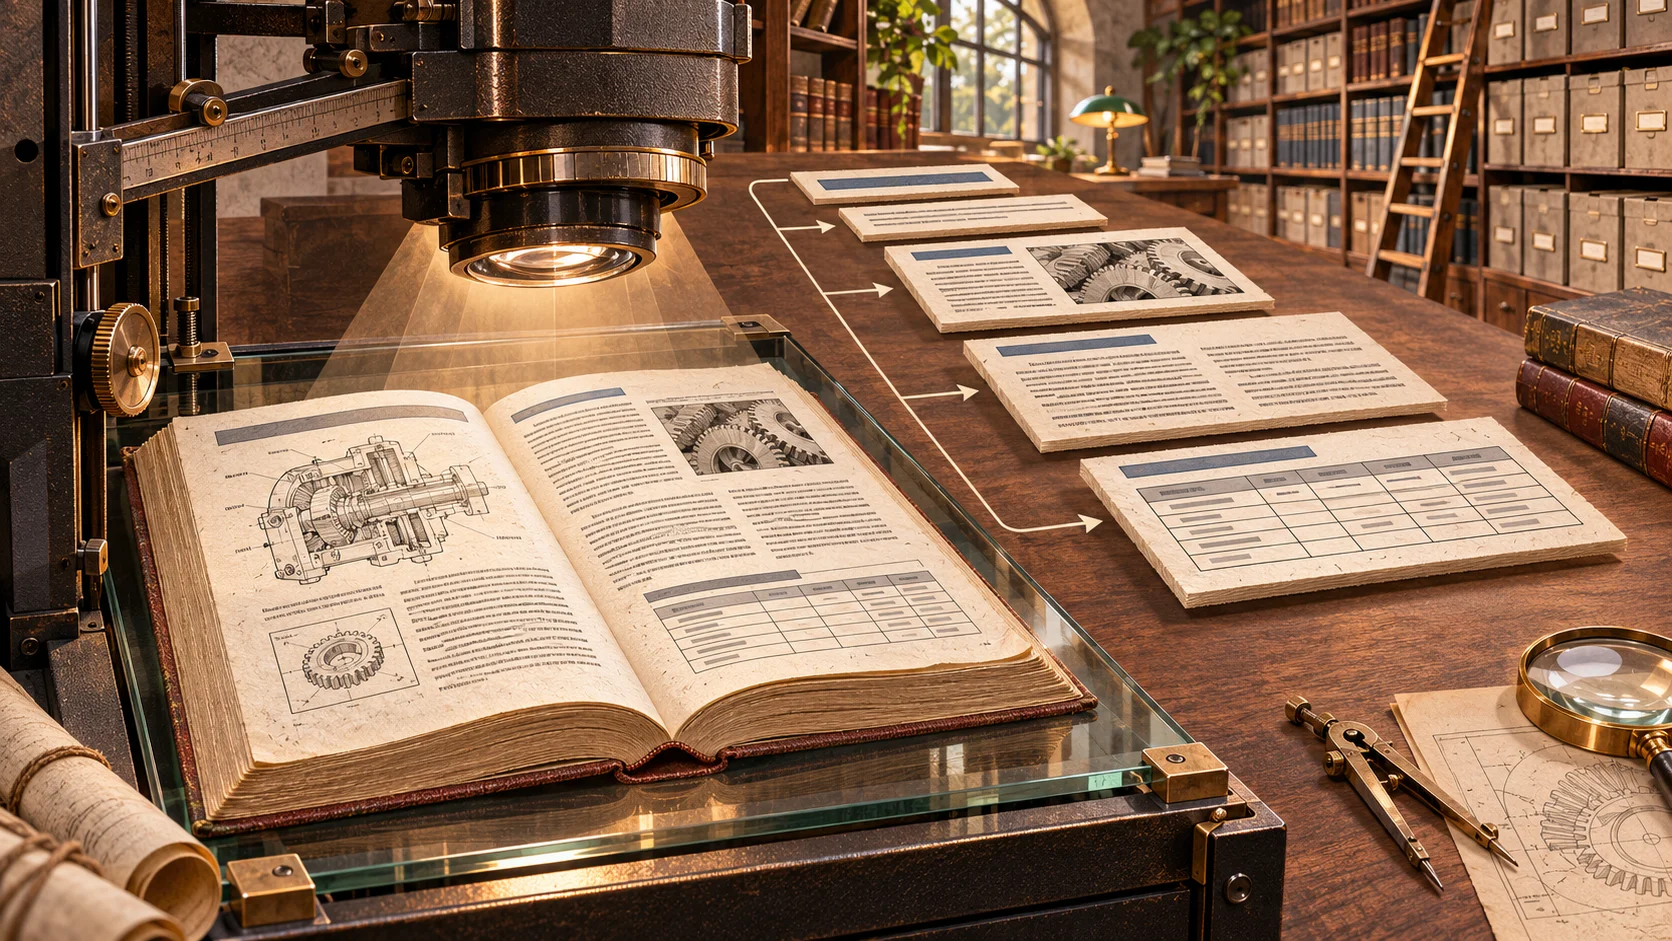
Google Cloud เพิ่มใน release notes วันที่ 2 พฤศจิกายน 2026 ว่า AI.PARSE_DOCUMENT ใน BigQuery เปิดใช้งานทั่วไปแล้ว ฟังก์ชันนี้รับเอกสารที่ไม่มีโครงสร้างและใช้ Document AI layout parser แยกชื่อเรื่อง หัวข้อ ย่อหน้า รายการ ตาราง และภาพออกมาเป็น JSON ภายใน SQL ขั้นตอนเดียว ทีมข้อมูลจึงสร้าง pipeline สำหรับค้นหา วิเคราะห์ หรือเตรียมข้อความให้ระบบ AI ได้โดยไม่ต้องตั้ง Document AI processor เองล่วงหน้า แต่ยังต้องเข้าใจขอบเขตไฟล์ สิทธิ์เข้าถึง และค่าใช้จ่ายต่อหน้า
จากไฟล์เอกสารเป็น JSON ที่ query ได้
AI.PARSE_DOCUMENT รับ Cloud Storage URI แบบ string หรือค่า ObjectRef จาก object table และฟังก์ชันใน BigQuery เช่น OBJ.LIST จึงเหมาะกับงานอ่านไฟล์จำนวนมากใน bucket ได้ด้วย SQL เดียว Google ระบุว่าสามารถใช้ ObjectRef สำหรับไฟล์ Google Drive ได้ แต่ไม่รองรับการส่ง Drive URI เป็น string โดยตรง เมื่อเรียกครั้งแรก BigQuery สร้าง Document AI layout parser ชื่อ bq-created-layout-parser ในโปรเจกต์ให้อัตโนมัติ และใช้ processor เดียวต่อโปรเจกต์เพื่อไม่สร้างซ้ำทุก query
รูปแบบผลลัพธ์มีสองแบบ ค่าเริ่มต้น layout-v1 เป็นรายการ block ตามลำดับการอ่าน โดยมีประเภทเนื้อหา หน้าและตำแหน่ง เหมาะกับการ query และจัดการใน SQL ส่วน raw-docai เก็บโครงสร้างแบบต้นไม้ของ Document AI สำหรับงานที่ต้องรักษาความสัมพันธ์หัวข้อกับเนื้อหา หรือส่งต่อให้ AI.CHUNK_DOCUMENT เพื่อแบ่งเอกสารเป็นชิ้นเชิงความหมาย ฟีเจอร์ chunking ใช้ได้เมื่อเลือก raw-docai เท่านั้น หากออกแบบ pipeline สำหรับ RAG แล้วใช้ schema ค่าเริ่มต้นโดยไม่ตรวจ อาจเจอข้อจำกัดตอนเชื่อมขั้นถัดไป
ตัวอย่างการใช้งานคือทีมคู่มือผลิตภัณฑ์เก็บ PDF ใน Cloud Storage แล้วใช้ AI.PARSE_DOCUMENT ดึงหัวข้อและตารางที่อยู่ในแต่ละหน้า นำ JSON มาจัดเป็น record พร้อมหมายเลขหน้า จากนั้นแบ่ง chunk สำหรับการค้นคืน เมื่อผู้ใช้ถามคำถาม ระบบจึงอ้างอิงส่วนเอกสารที่ถูกต้องได้ดีกว่าการตัดข้อความตามจำนวนอักขระอย่างเดียว อย่างไรก็ตาม parsing ไม่ใช่การรับรองความถูกต้องของข้อมูลในเอกสาร ผู้พัฒนาควรตรวจตัวอย่างตาราง หน้าเอียง และเอกสารที่มีภาพประกอบด้วยคนก่อนนำไปใช้ตอบคำถาม
ข้อจำกัดที่ต้องใส่ใน pipeline
คู่มือ Google ระบุว่าเอกสารยาวได้สูงสุด 130 หน้า และยังเลือกช่วงหน้าบางส่วนไม่ได้ ฟังก์ชันรองรับเฉพาะชนิดไฟล์ที่ Document AI layout parser จัดการได้ จึงต้องคัดกรองชนิดและขนาดไฟล์ก่อนส่งเข้าประมวลผล สำหรับ Drive ต้องใช้ ObjectRef ตามที่กล่าว และต้องเปิด Document AI API ก่อนใช้งาน การพิสูจน์ตัวตนเลือกใช้ end-user credentials เป็นค่าเริ่มต้น หรือระบุ BigQuery Cloud resource connection ที่มีสิทธิ์เหมาะสม ทีมควรทดสอบสิทธิ์กับไฟล์ที่ผู้ใช้บางกลุ่มอ่านไม่ได้เพื่อป้องกัน pipeline ที่ทำงานเฉพาะบัญชีผู้ดูแล
ต้นทุนมีสองส่วน Document AI Layout Parser คิดตามจำนวนหน้าที่ประมวลผล และ BigQuery คิดการใช้ query slot ตามปกติ ไม่มีค่าถือ processor ไว้เฉย ๆ หากลบ processor ที่สร้างอัตโนมัติ BigQuery จะสร้างใหม่เมื่อเรียกครั้งถัดไป การรัน query ซ้ำบนไฟล์ชุดเดิมจึงอาจประมวลผลและคิดเงินซ้ำ ควรเก็บผล JSON พร้อมเวอร์ชันไฟล์หรือ hash แล้วประมวลผลเฉพาะไฟล์ที่เปลี่ยน
ฟังก์ชันรองรับ US และ EU multi-regions รวมถึง single regions ส่วนใหญ่ในสองพื้นที่นี้ แต่ไม่รองรับ europe-west2 และ europe-west6 ตามคู่มือ ณ วันที่ประกาศ ทีมที่ต้องวางข้อมูลในเอเชียหรือ Region ยกเว้นจึงไม่ควรสมมติว่าเรียกได้ทันที ก่อนใช้งานจริงควรทดลองกับไฟล์อ้างอิงหลายรูปแบบ ตรวจ JSON schema, สิทธิ์, latency และต้นทุนต่อเอกสาร แล้วจึงกำหนดวิธีเก็บผลและการลบข้อมูลตามนโยบายองค์กร
แหล่งข่าว: Google Cloud release notes วันที่ 2 พฤศจิกายน 2026 และ คู่มือ AI.PARSE_DOCUMENT