Google สาธิต BigQuery อ่าน Iceberg ข้ามคลาวด์โดยไม่ย้ายข้อมูลทั้งหมด
แนวทาง borderless Lakehouse ใช้ Iceberg REST catalog เชื่อม Databricks, Snowflake และ AWS Glue เพื่อวิเคราะห์ข้ามคลาวด์ พร้อมข้อควรตรวจด้านสิทธิ์และต้นทุน
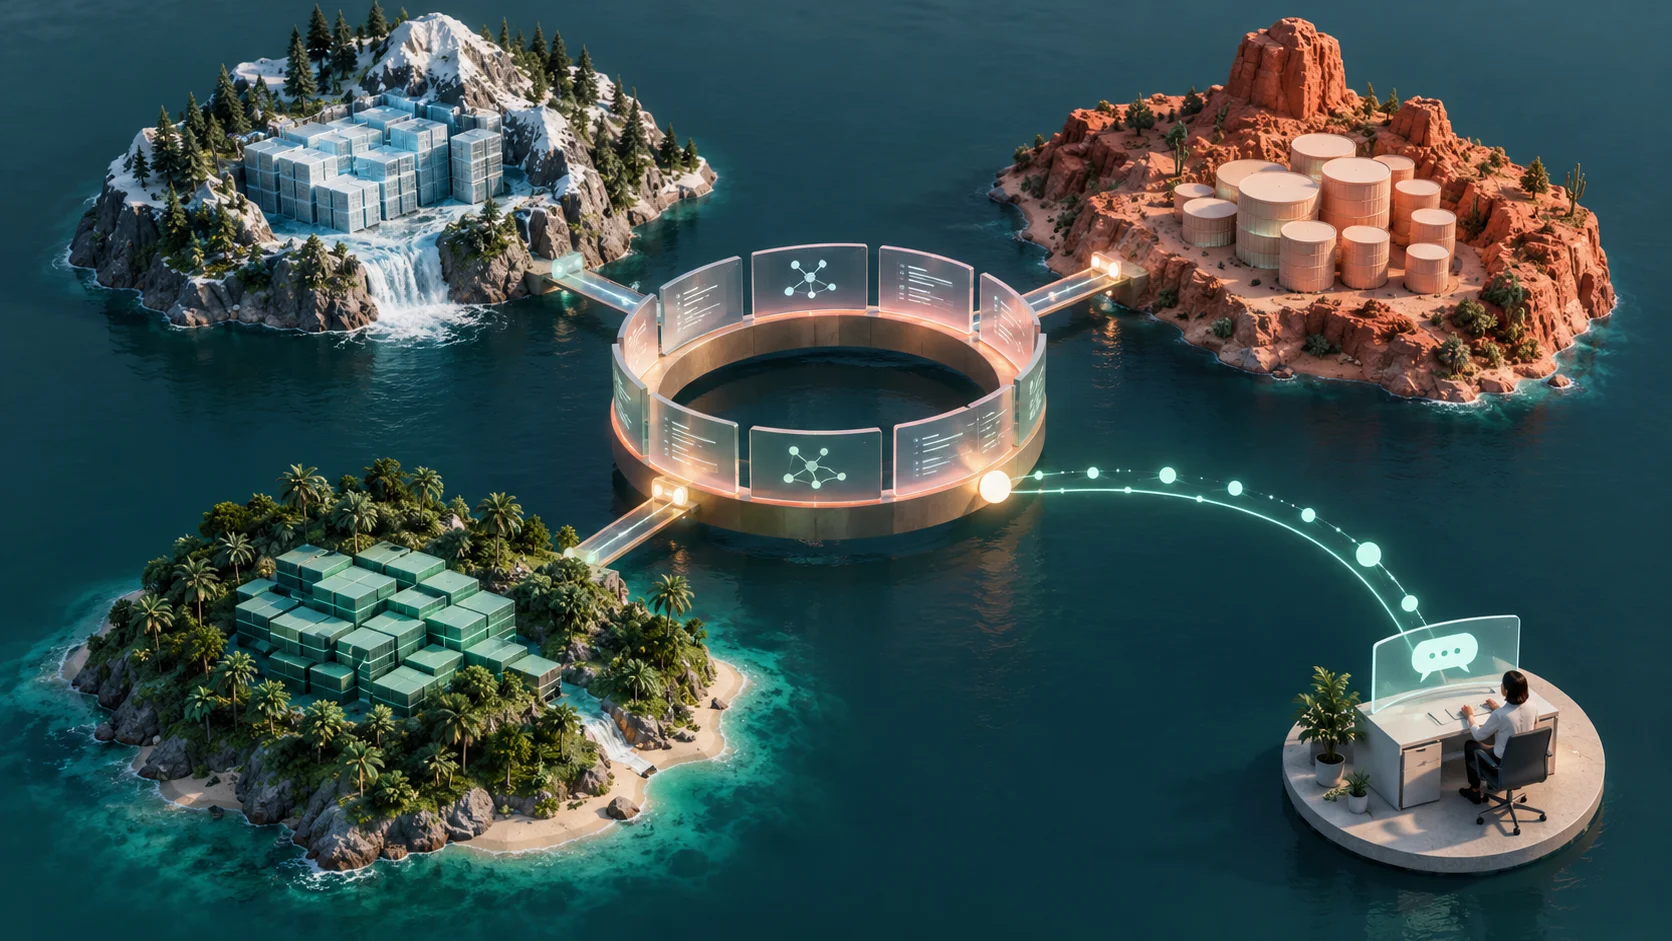
ข้อมูลขององค์กรจำนวนมากอยู่คนละคลาวด์และคนละ catalog การจะวิเคราะห์ร่วมกันจึงมักต้องคัดลอกข้อมูลมารวม ซึ่งทำให้เกิดค่าเก็บข้อมูลเพิ่ม ความล่าช้าจากการซิงก์ และค่า egress วันที่ 13 ตุลาคม 2026 Google Cloud เผยแพร่แนวทางใช้ BigQuery กับ borderless Lakehouse เพื่ออ่านตาราง Apache Iceberg จาก catalog ภายนอก และต่อยอดเป็นการถามข้อมูลด้วยภาษาธรรมชาติ บทความต้นทางเป็นแนวทางทางเทคนิค ไม่ใช่ประกาศว่าทุกระบบเชื่อมกันได้โดยไม่ต้องตั้งค่าสิทธิ์
แนวคิดหลักคือย้าย metadata แทนย้ายข้อมูลทั้งหมด
ตัวอย่างของ Google ใช้ Apache Iceberg REST catalog เป็นชั้นเชื่อมระหว่าง Google Cloud กับ Databricks Unity Catalog, Snowflake Horizon Catalog และ AWS Glue Data Catalog เมื่อสร้าง federated catalog แล้ว Lakehouse runtime catalog จะซิงก์ metadata เช่น schema, snapshot pointer และนิยามตารางตามรอบ refresh ที่ตั้งไว้ ส่วนตอน query engine ที่เข้ากันได้จะอ่านไฟล์ Parquet จาก object storage ภายนอกโดยตรงด้วยข้อมูลรับรองชั่วคราว วิธีนี้แยกการรู้ว่า “ตารางอยู่ที่ไหน” ออกจากการคัดลอกไฟล์ทั้งหมดมาเก็บใหม่
Google ระบุว่า query processing ทำใน BigQuery หรือ Managed Service for Apache Spark ฝั่ง Google Cloud ไม่ได้เปิด Databricks cluster หรือ Snowflake virtual warehouse ขึ้นมาประมวลผลแทน ข้อนี้ช่วยให้เห็นตำแหน่งของต้นทุน compute แต่ไม่ได้แปลว่าการอ่านข้อมูลข้ามคลาวด์ไม่มีค่าใช้จ่ายด้านเครือข่ายหรือ latency ทีมที่สนใจต้องคำนวณปริมาณข้อมูลที่อ่านจริง ค่า egress จากแหล่งข้อมูล และผลของการทำ partition pruning ก่อนสรุปว่าคุ้มกว่าการทำสำเนา
ตัวอย่างขั้นตอนเชื่อมต่อ
ในกรณี Databricks เอกสารให้สร้าง catalog และ Iceberg table ใน Unity Catalog เปิด external data access สำหรับ metastore แล้วสร้าง service principal ที่มีสิทธิ์เข้าถึง schema ที่ต้องการ จากนั้นใช้ gcloud alpha biglake iceberg catalogs create สร้าง federated catalog พร้อมกำหนดชนิด unity และรอบ refresh เมื่อสร้างสำเร็จจึงตรวจ service account ที่ Google Cloud ออกให้ แล้วกลับไปให้สิทธิ์ฝั่ง Databricks รวมถึง EXTERNAL USE SCHEMA เพื่อให้เกิดการออก credential สำหรับอ่านข้อมูลภายนอก
ลำดับนี้ชี้ว่าระบบไม่ได้ข้ามการกำกับสิทธิ์ เจ้าของข้อมูลยังต้องอนุมัติว่า identity ใดเห็น metadata และอ่านไฟล์ใดได้ ความผิดพลาดที่พบบ่อยในงานลักษณะนี้คือให้สิทธิ์ browse catalog ได้แต่ไม่ได้ให้สิทธิ์อ่าน data file จริง หรือเปิดสิทธิ์กว้างเกินเพราะต้องการให้ demo ผ่าน ทีมควรแยก service identity สำหรับการทดลอง จำกัด dataset ที่ใช้ และตรวจ audit log ทั้งสองฝั่งหลังรัน query
ตัวอย่างในบทความยังแสดงรูปแบบสำหรับ Snowflake และ AWS Glue ด้วย สำหรับ Snowflake มีการสร้าง reader role และใช้ Workload Identity Federation เพื่อผูก identity ฝั่ง Google กับ service user แบบไม่ต้องตั้งรหัสผ่านถาวร ส่วน AWS ต้องเตรียม IAM role และสิทธิ์ใน Glue กับ S3 รายละเอียดเหล่านี้ทำให้เห็นว่ามาตรฐาน Iceberg REST ช่วยลดความแตกต่างของ interface แต่ไม่ได้ลบความแตกต่างด้าน IAM ของแต่ละผู้ให้บริการ
การถามข้อมูลด้วยภาษาธรรมชาติ
เมื่อ metadata จากหลาย catalog ถูกนำมาให้ BigQuery มองเห็น Google สาธิตการ join ตารางข้ามแหล่งและใช้ conversational analytics เพื่อสำรวจข้อมูลรวมด้วยคำถามภาษาธรรมชาติ ประโยชน์ที่เป็นไปได้คือผู้วิเคราะห์เริ่มค้นข้อมูลได้เร็วขึ้นโดยไม่ต้องจำชื่อทุกตาราง แต่ทีมข้อมูลยังต้องตรวจ SQL ที่ถูกสร้าง ความหมายของ metric และข้อจำกัดของข้อมูลต้นทาง โดยเฉพาะกรณีชื่อคอลัมน์เหมือนกันแต่มีนิยามต่างกัน การถามได้ง่ายไม่เท่ากับได้คำตอบถูกต้องโดยอัตโนมัติ
ก่อนเปิดให้ผู้ใช้ทั่วไปถามข้อมูล ควรทำ semantic definition สำหรับตัวเลขสำคัญ ระบุ timezone และช่วงเวลาของ snapshot ให้ชัด และทดสอบคำถามที่มีคำตอบอ้างอิงได้ การซิงก์ metadata เป็นรอบอาจทำให้ schema ที่เพิ่งเปลี่ยนยังไม่ปรากฏทันที ทีมจึงต้องกำหนด SLA ของความสดของ metadata และวิธีแจ้งผู้ใช้เมื่อคำตอบอาจอาศัยภาพเก่าของตาราง
ควรทดลองอย่างไร
เลือกข้อมูลที่ไม่อ่อนไหวจากสอง catalog ก่อน ทำ query เดียวกันผ่าน federation และวิธีเดิม แล้ววัดเวลา ค่าใช้จ่าย และความถูกต้อง ทดสอบกรณีตารางเปลี่ยน schema, credential หมดอายุ, region ต่างกัน และบริการต้นทางไม่พร้อม ตรวจด้วยว่าผู้ใช้ที่ไม่มีสิทธิ์ในแหล่งข้อมูลไม่สามารถใช้ BigQuery เป็นทางลัดเข้าไปอ่านได้ เมื่อได้ตัวเลขจึงตัดสินใจว่าตารางใดเหมาะกับการอ่านตรง และตารางใดยังคุ้มกว่าถ้าทำสำเนาหรือ materialize ตามรอบ
สรุป
แนวทางที่ Google Cloud เผยแพร่วันที่ 13 ตุลาคม 2026 แสดงวิธีใช้มาตรฐาน Apache Iceberg REST catalog เพื่อรวมการมองเห็นข้อมูลจากหลายคลาวด์โดยไม่เริ่มจากการย้ายข้อมูลทั้งหมด เหมาะกับทีมที่มี Iceberg อยู่แล้วและต้องการทดลองวิเคราะห์ข้าม catalog แต่ผลด้านต้นทุน ความเร็ว และความปลอดภัยยังขึ้นกับตำแหน่งไฟล์ สิทธิ์ และรูปแบบ query จริงขององค์กร
แหล่งข่าวและวันที่เผยแพร่: Google Cloud Blog, 13 ตุลาคม 2026