Amazon ECS แชร์ GPU ด้วย NVIDIA MPS ได้แล้ว: จัดงาน Inference หลาย Task บนการ์ดเดียว
AWS เพิ่ม GPU sharing ผ่าน NVIDIA MPS ใน Amazon ECS ให้หลาย task ใช้ GPU เดียวกันได้ พร้อมข้อจำกัดเรื่อง memory, compute, isolation และการเฝ้าระวัง
Amazon ECS แชร์ GPU ด้วย NVIDIA MPS ได้แล้ว: จัดงาน Inference หลาย Task บนการ์ดเดียว
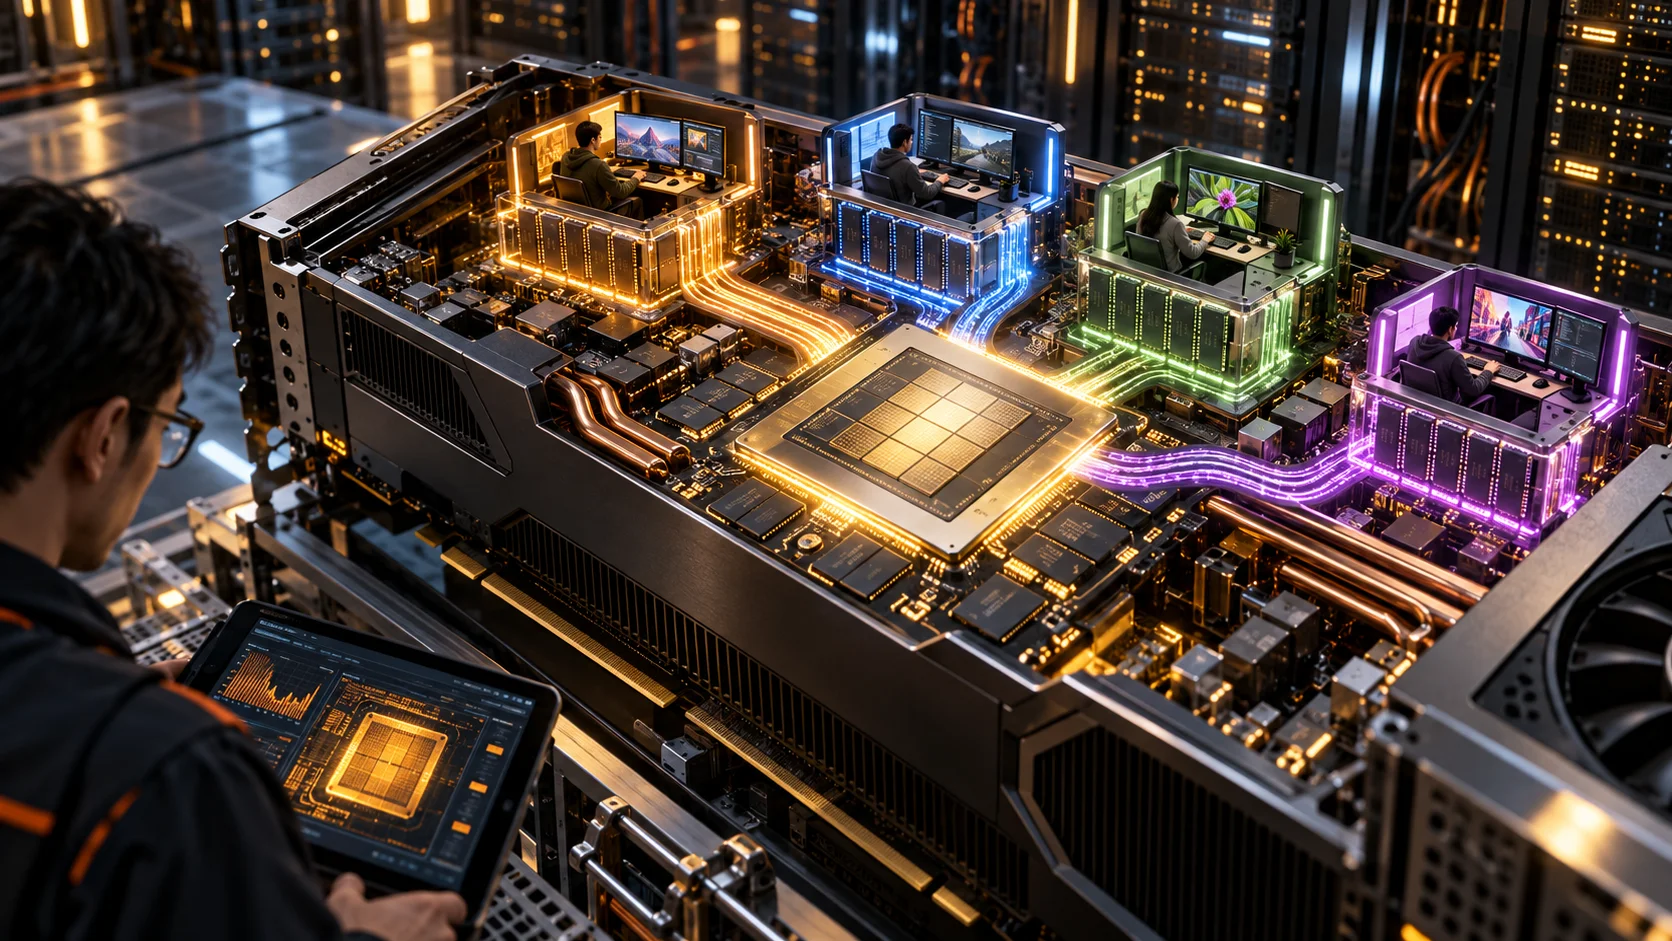
AWS ประกาศวันที่ 27 ตุลาคม 2026 ว่า Amazon ECS รองรับการแชร์ NVIDIA GPU ผ่าน Multi-Process Service หรือ MPS ทำให้หลาย ECS tasks รันพร้อมกันบน GPU ใบเดียวได้ ความสามารถนี้มุ่งลด GPU ที่ว่างอยู่ในงานซึ่งใช้ทรัพยากรไม่เต็มการ์ด เช่น inference โมเดลขนาดเล็ก การสร้าง embedding และ multi-model serving ผู้พัฒนาระบุหน่วยความจำ GPU ที่แต่ละ container ต้องใช้ และกำหนดเพดานการใช้ compute ได้เป็นทางเลือก จากนั้น ECS วาง task ตามพื้นที่หน่วยความจำ GPU ที่เหลือ ฟีเจอร์ใช้ได้ทั้ง ECS Managed Instances และ ECS บน EC2 โดย AWS ระบุว่าเปิดใน commercial regions และ GovCloud (US)
เหตุผลที่ควรสนใจไม่ใช่แค่ทำให้จำนวน task ต่อเครื่องสูงขึ้น แต่เป็นการเปลี่ยนหน่วยที่ใช้วางแผนต้นทุน หากงาน inference หนึ่งตัวใช้ GPU เพียงบางส่วน การจอง GPU ทั้งใบให้ task เดียวทำให้ส่วนที่เหลือไม่ถูกใช้งาน การแชร์เปิดทางให้รวมหลายงานบนฮาร์ดแวร์เดิม แต่ผลจริงต้องวัด latency, throughput, peak memory และความเสี่ยงจากการรบกวนกันระหว่างงาน ไม่ควรคำนวณว่าต้นทุนจะลดตามจำนวน task ที่ยัดลงการ์ดโดยตรง
MPS กับการจัดวางของ ECS
คู่มือ Amazon ECS อธิบายว่า MPS เป็นการแชร์ระดับซอฟต์แวร์ของ NVIDIA CUDA ที่ให้หลาย process ใช้ GPU พร้อมกัน ECS เริ่ม MPS daemon จัดวาง container และบังคับเพดานทรัพยากรต่อ container ใน task definition ต้องใช้ sharingStrategy.nvidiaMps.memory แทนการขอ GPU ทั้งใบด้วย value ค่า memory เป็น MiB และเป็นเพดานหน่วยความจำที่ container ใช้ได้ ส่วน maxComputePercent เป็นตัวเลือกช่วง 1 ถึง 100 ที่จำกัด compute สูงสุด ไม่ใช่การจอง compute ขั้นต่ำ
จุดที่อาจทำให้วางแผนผิดคือ ECS จัดวางจากหน่วยความจำ GPU ที่ขอ ไม่ได้ใช้ compute ceiling เป็นเกณฑ์ placement หากวางหลาย task ที่แต่ละตัวใช้ memory น้อยแต่ต้องการคำนวณหนักพร้อมกัน งานอาจแย่ง compute จน latency พุ่ง แม้ทุก task จะเริ่มได้สำเร็จ ทีมจึงควรทดสอบภายใต้ทราฟฟิกจริงและดู tail latency ของแต่ละบริการ โดยเฉพาะเมื่อรวมงานที่มีรูปแบบโหลดต่างกันไว้บนการ์ดเดียว
เงื่อนไขการตั้งค่าและข้อจำกัด
Container ที่ใช้ GPU ใน task เดียวกันต้องใช้แนวทางแชร์แบบเดียวกัน ไม่สามารถให้บางตัวใช้ sharingStrategy แล้วอีกตัวขอ GPU เฉพาะด้วย value ใน task เดียวกันได้ และไม่สามารถใส่ sharingStrategy ผ่าน container override ตอน RunTask หรือ StartTask ต้องกำหนดไว้ใน task definition ก่อน สำหรับ ECS on EC2 ต้องใช้ ECS container agent ตั้งแต่ 1.107.0 และ ECS AL2023 GPU-optimized AMI รุ่น 20261019 หรือใหม่กว่า เอกสารระบุ instance families ที่รองรับ เช่น G4dn, G5, G6, G6e, G7, P3, P4d, P5 และ P6-B200 แต่ฟีเจอร์นี้ไม่รองรับ Fargate, ECS Express Mode หรือ ECS Anywhere
AWS เตือนว่าการแชร์แบบ MPS ไม่ใช่การแยกฮาร์ดแวร์อย่างเด็ดขาด หาก container หนึ่งทำให้ GPU เกิด fatal error เช่น illegal memory access งานอื่นบน GPU ใบเดียวกันอาจได้รับผลกระทบด้วย จึงไม่เหมาะกับงานที่ต้องการ isolation ระดับฮาร์ดแวร์ หรือ training โมเดลขนาดใหญ่ที่ใช้หน่วยความจำเต็มการ์ด นอกจากนี้หากแอปหนึ่ง container เปิดหลาย GPU processes ต้องคำนวณ memory จาก peak รวมและควบคุมที่ระดับแอป เพราะการใช้จริงอาจเกินค่าที่แจ้งจนแย่งหน่วยความจำกับงานอื่น
เริ่มทดลองแบบควบคุมความเสี่ยง
เลือกบริการ inference ที่ใช้ GPU ต่ำและมีการวัดผลอยู่แล้ว บันทึก baseline ของจำนวนคำขอ latency โดยเฉพาะ p95/p99 อัตรา error และการใช้ GPU ก่อนเปิดแชร์ จากนั้นสร้าง capacity provider ที่ใช้ NVIDIA GPU instance และ task definition ใหม่ที่ระบุ memory ตาม peak จริงพร้อมเผื่อ headroom หากจำเป็นให้ตั้ง compute ceiling แต่ต้องเข้าใจว่าเป็นเพดานไม่ใช่การรับประกัน ลองรันสองบริการพร้อมกัน เพิ่มโหลดทีละขั้น และดูว่าบริการหนึ่งทำให้อีกบริการช้าลงเมื่อใด
ใน ECS Managed Instances ระบบตรวจสุขภาพ GPU และ MPS daemon หาก daemon เสียหรือ GPU มีปัญหา ECS จะ drain และเปลี่ยน instance แล้วจัด task ไปยัง capacity ที่ดี แต่ทีมยังต้องออกแบบการรับคำขอระหว่างย้าย task ให้เหมาะกับบริการของตน และตรวจว่า rollout ไม่ทำให้จำนวน instance เพิ่มจนต้นทุนสวนทางกับเป้าหมาย ถ้าต้องแยกงานสำคัญไม่ให้แชร์ GPU กับบริการอื่น เอกสารแนะนำใช้ capacity provider หรือ cluster แยกกัน
สิ่งที่ต้องเปลี่ยนในการเฝ้าระวัง
การวัดผลหลังเปิดแชร์ต้องปรับด้วย เพราะเอกสารระบุว่า metric GPU utilization และ GPU memory ระดับ task/container บางชุดไม่ถูกส่งสำหรับ GPU ที่แชร์ด้วย MPS แต่ metric อย่าง power draw, temperature, App Xid restart และ metric ระดับ instance ยังมีอยู่ สามารถใช้ DescribeContainerInstances ตรวจ sharing mode จำนวน container และ memory ที่เหลือบน GPU รวมทั้ง DescribeTasks ตรวจ strategy ของแต่ละ container อย่าตัดสินว่าระบบไม่มีปัญหาเพียงเพราะกราฟ utilization ระดับ task หายไป ให้เพิ่ม metric ของแอปและผลตอบสนองผู้ใช้เป็นตัววัดหลัก
ข่าวนี้เหมาะกับทีมที่มี GPU ต้นทุนสูงแต่ workload ขนาดเล็กหลายชุด การทดลองควรตอบให้ได้ว่าเพิ่มจำนวน task ได้เท่าไรโดย latency ยังอยู่ในเกณฑ์ และเมื่อ task หนึ่งล้ม งานอื่นได้รับผลอย่างไร เมื่อมีตัวเลขเหล่านี้จึงค่อยขยายไปยังบริการ production การแชร์ GPU ช่วยให้ใช้ฮาร์ดแวร์คุ้มขึ้นได้จริงในบางรูปแบบงาน แต่ความคุ้มค่าและความเสี่ยงต้องวัดจาก workload ของแต่ละทีม
แหล่งข้อมูล: ประกาศ AWS วันที่ 27 ตุลาคม 2026 และ คู่มือ Share GPUs on Amazon ECS