BigQuery Python UDF ส่ง Structured Logs เข้า Cloud Logging ได้ตรง ช่วยคัดแถวข้อมูลเสีย
Google Cloud เพิ่ม logging ใน Python UDF พร้อมตัวอย่าง alert และ replay ข้อมูลที่ถูกกันออก
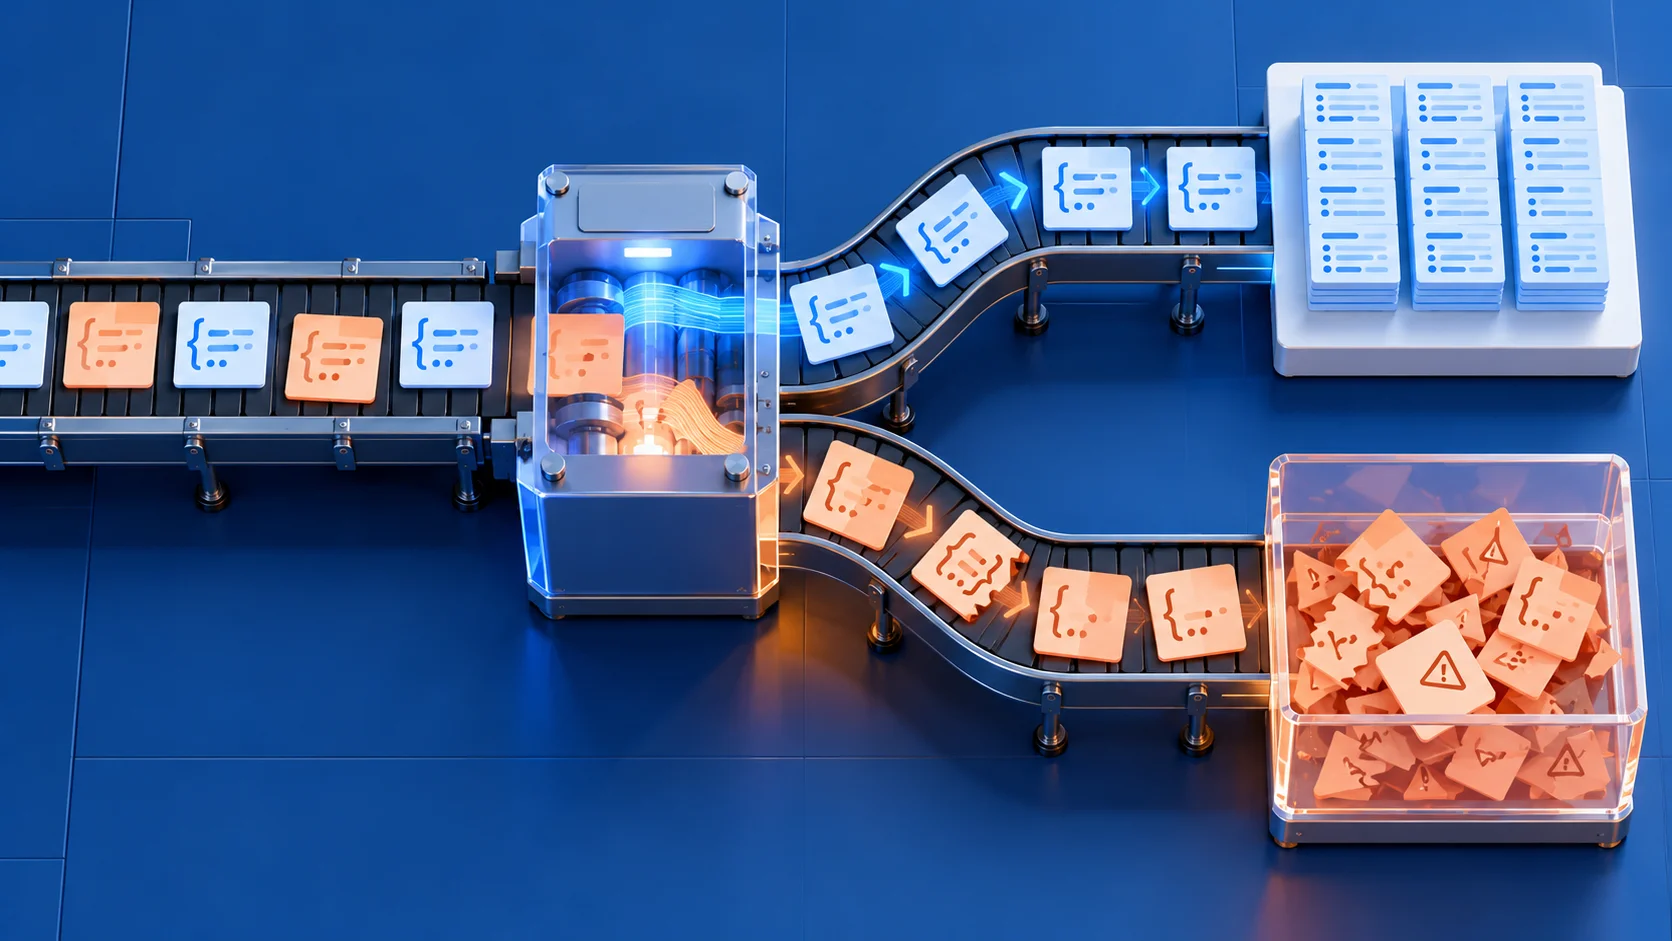
Google Cloud เผยแพร่เมื่อ 19 ตุลาคม 2026 ว่า Python User-Defined Functions (UDF) ใน BigQuery สามารถใช้ logging มาตรฐานของ Python เพื่อส่ง structured logs ไป Cloud Logging ได้โดยตรง ไม่ต้องติดตั้ง plugin หรือ connector เพิ่ม ความสามารถนี้ช่วยให้ pipeline แยกแถวข้อมูลเสียออกจากผลลัพธ์ได้ โดยไม่ต้องทำให้ query ทั้งงานล้มเหลวทันที
ปัญหาที่ฟีเจอร์นี้แก้
ในงาน ingest JSON จากอีคอมเมิร์ซ ข้อมูลบางแถวอาจเป็น JSON ไม่ถูกต้องหรือขาด user_id หาก UDF โยน exception ทุกครั้ง query อาจหยุดและข้อมูลดีไม่ได้เข้า destination table Google แสดงตัวอย่าง UDF ที่ parse payload ถ้าพบช่องว่างหรือรูปแบบผิด จะ logging.warning() หรือ logging.error() พร้อมข้อมูลวินิจฉัย แล้วคืน NULL เพื่อให้ SQL กรองแถวเสียออกไป ผลคือแถวดีเข้าสู่ตารางต่อ ขณะที่แถวเสียมีร่องรอยใน Cloud Logging ให้ทีมตรวจ
ตัวอย่างของ Google ใช้ SET @@udf.properties = JSON '{"enableDebugOutput": true}' เพื่อเปิด logging ใน session จากนั้นสร้างตารางจากแถวตัวอย่างที่มีทั้ง click, view และ checkout แถวที่ไม่มี user_id กับ JSON เสียไม่เข้าสู่ clean_events แต่ถูกบันทึกเป็น log แนวทางนี้ไม่ควรถูกตีความว่าการคืน NULL อย่างเดียวเท่ากับการจัดการข้อมูลผิดครบแล้ว เพราะทีมต้องกำหนดวิธี replay และนับอัตราแถวเสียด้วย
วงจรสังเกตการณ์ที่ประกาศ
Google แนะนำสามขั้น: validation ใน Python UDF, alert ผ่าน Cloud Monitoring log-based metric และ triage/replay ด้วย SQL ผ่าน BigQuery Log Analytics ใน Logs Explorer สามารถกรอง resource.type="bigquery.googleapis.com/ManagedRoutineInvocation" และ severity>=ERROR เพื่อดูปัญหาของ UDF แล้วตั้ง alert เมื่อ error rate เกินเกณฑ์ ทีมที่ต้อง query log ด้วย BigQuery ต้องเปิด Log Analytics บน log bucket และสร้าง linked dataset ก่อน จึงจะเห็น _AllLogs view
การเก็บ error_type, missing_key และตัวอย่าง raw_payload ช่วยวิเคราะห์ว่า upstream ส่งข้อมูลผิดแบบใด แต่ raw payload อาจมีข้อมูลส่วนบุคคลหรือ secret จึงควรจำกัด field ที่ log, mask ค่าอ่อนไหว และตั้ง retention/สิทธิ์ Cloud Logging ตามนโยบายองค์กร ตัวอย่างในบล็อกตัด payload เหลือ 200 ตัวอักษรใน error บางกรณี แต่ยังต้องประเมินว่าข้อความส่วนนี้เผยข้อมูลอะไรได้บ้าง
วิธีนำไปทดลอง
เริ่มจาก dataset ทดสอบที่มีข้อมูลถูกและผิดแบบควบคุมได้ สร้าง UDF ให้แยกประเภท error แล้วรัน query ที่เปิด debug output ตรวจจำนวนแถวที่ผ่าน จำนวน log ที่เกิด และค่าใช้จ่ายจากการเก็บ/ค้น log ก่อนย้ายไป production กำหนด threshold การแจ้งเตือนที่สัมพันธ์กับอัตรา ไม่ใช่แค่จำนวน log เพราะปริมาณ traffic เปลี่ยนได้ ทดลอง replay แถวเสียลงตารางใหม่และใส่ idempotency key เพื่อไม่ให้ข้อมูลซ้ำเมื่อรันซ้ำ
ฟีเจอร์ใหม่ทำให้ Python UDF เป็นจุดสังเกตข้อมูลระดับแถวได้ดีขึ้น แต่ไม่ได้แก้ data quality โดยอัตโนมัติ ข้อสำคัญคือ pipeline ยังมีหลักฐานของข้อมูลที่ถูกกันออก และทีมมีขั้นตอนคืนข้อมูลหลังแก้ upstream แล้ว
ประกาศต้นทาง: https://cloud.google.com/blog/products/data-analytics/python-udf-logging-for-pipeline-observability-in-bigquery